Qui va le dire aux vibe coders?
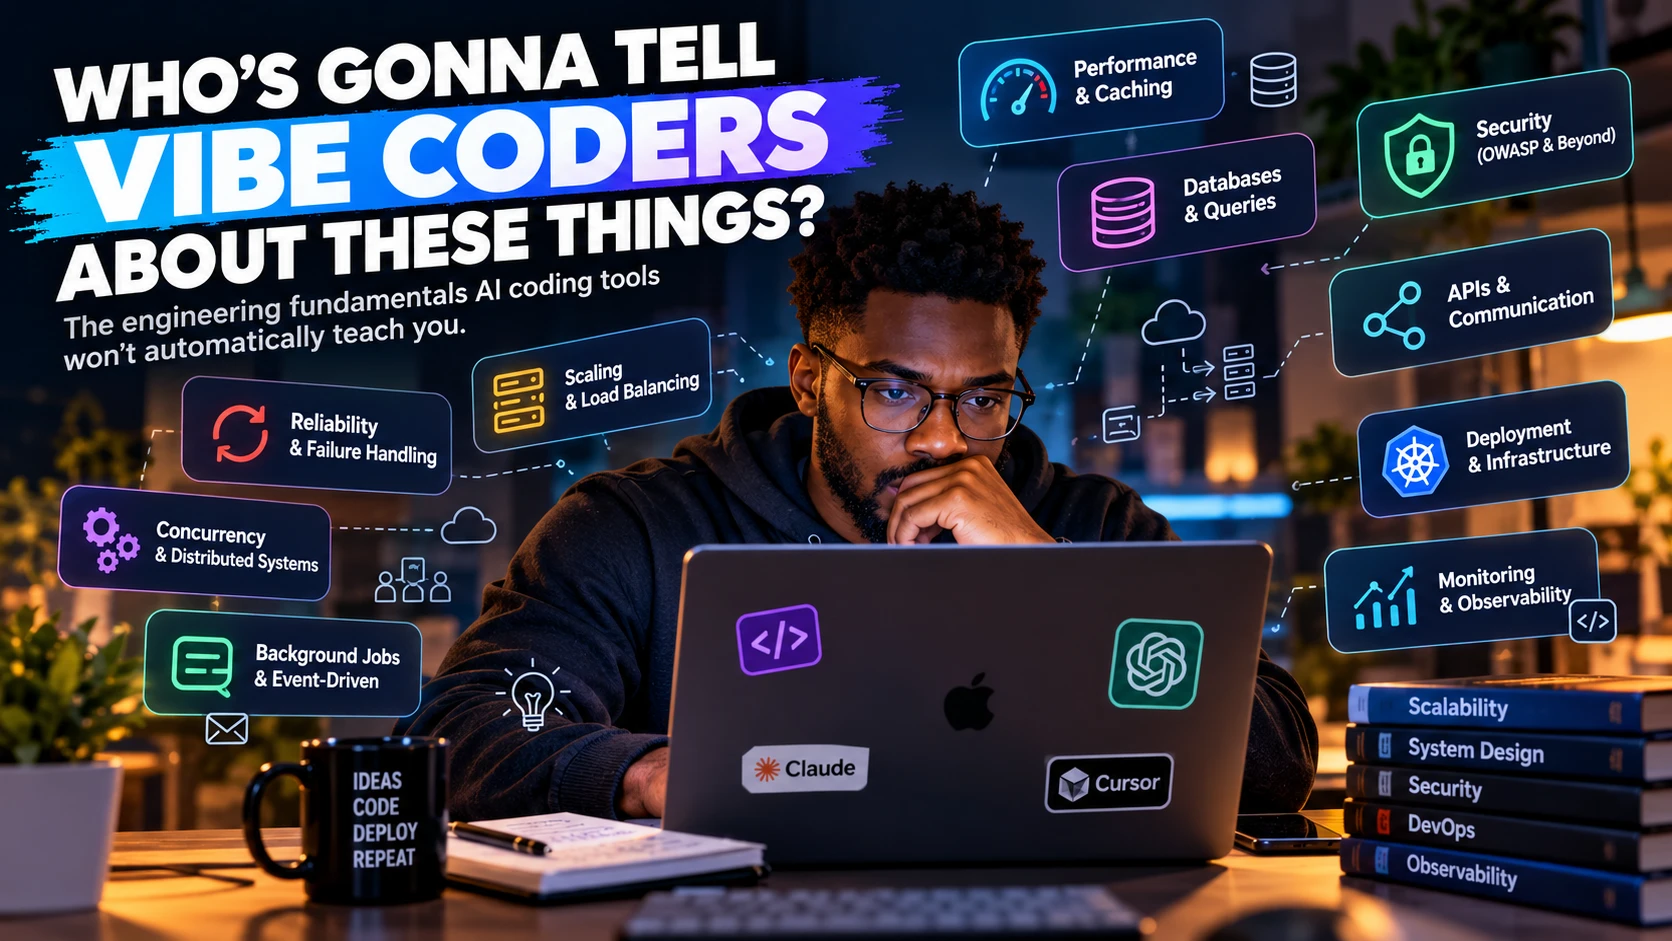
L’IA peut créer votre app. Mais savez-vous ce qui arrive quand 5 000 personnes l’utilisent, que votre base de données ralentit ou que votre fournisseur de paiement tombe en panne?
Le vibe coding a changé la façon de créer des logiciels. Avec Claude Code, Cursor et d’autres assistants de code IA, vous pouvez décrire une idée, générer des composantes, brancher une base de données, ajouter l’authentification et livrer une app fonctionnelle sans écrire chaque ligne vous-même.
C’est une bonne chose. Plus de gens peuvent expérimenter, lancer des produits et transformer leurs idées en vraies entreprises, et les développeurs passent moins de temps sur les tâches répétitives.
Mais il y a un hic : faire fonctionner quelque chose, ce n’est pas la même chose que comprendre pourquoi ça fonctionne, ce qui pourrait le briser et comment le réparer quand ça arrive.
Votre app peut fonctionner parfaitement avec cinq utilisateurs de test. Que se passe-t-il quand 5 000 arrivent? Si deux personnes achètent le dernier billet au même moment? Si votre fournisseur de paiement débite un client, mais que votre app ne reçoit jamais la confirmation? Si votre code généré par l’IA envoie une clé secrète au navigateur?
Ce ne sont pas des cas rares. Ce sont des problèmes d’ingénierie de tous les jours.
Je suis tombé sur une liste sur TikTok (partagée par Tech With Kingsley) de plus de 100 notions que les vibe coders devraient connaître : cache, indexation, situations de concurrence, systèmes distribués, sécurité, stratégies de déploiement, reprise après sinistre et plus encore. Plutôt que de simplement répéter les termes, je les ai regroupés en dix domaines et j’explique chacun en langage simple, avec des exemples.
Vous n’avez pas à tout maîtriser avant de créer. Vous devez reconnaître quand l’une de ces notions s’applique à ce que vous construisez.
1. Performance et cache : pourquoi mon app est-elle soudainement lente?
Une app peut sembler rapide en développement et devenir terriblement lente à mesure que les utilisateurs, les requêtes et les données augmentent. Travailler la performance, c’est trouver où le temps est réellement passé.
Le cache conserve le résultat d’un travail coûteux pour éviter de le refaire à chaque requête. Une place de marché automobile qui montre les mêmes annonces à des milliers de visiteurs peut mettre cette réponse en cache au lieu de la reconstruire chaque fois.
L’invalidation du cache est la partie difficile : décider quand une copie en cache est périmée et la retirer ou la rafraîchir. Quand une voiture est vendue, vous ne voulez pas d’une page en cache qui l’affiche encore comme disponible.
CDN et cache en périphérie. Un réseau de diffusion de contenu (CDN) sert les fichiers à partir de serveurs proches de vos utilisateurs. Le cache en périphérie garde des copies du contenu cachable (images, scripts, feuilles de style, parfois des pages entières) à ces endroits, pour que les requêtes voyagent moins loin et que votre serveur travaille moins.
Latence, débit et latence de queue décrivent différentes facettes de la vitesse :
- Latence : le temps que prend une opération.
- Débit : la quantité de travail que le système accomplit par seconde (ou par minute).
- Latence de queue : la lenteur de vos requêtes les plus lentes.
- Latence P99 : le temps sous lequel 99 % des requêtes se terminent. Le 1 % le plus lent prend plus de temps.
Un temps de réponse moyen de 100 ms semble excellent, mais si 1 % des requêtes prennent plusieurs secondes, beaucoup de vraies personnes passent quand même un mauvais moment. C’est pourquoi les équipes surveillent le P95/P99, pas seulement la moyenne.
Le cache de compilation permet aux outils de compilation de réutiliser les résultats précédents quand les entrées n’ont pas changé, ce qui accélère les compilations locales et les pipelines CI/CD.
Pourquoi c’est important : une démo rapide ne prouve pas qu’une app est rapide. Mesurez de vraies charges, trouvez le véritable goulot d’étranglement et corrigez-le, plutôt que de deviner.
2. Bases de données et requêtes : là où la plupart des apps lentes ralentissent vraiment
L’indexation. Un index permet à la base de données de trouver des lignes sans parcourir toute la table. Chercher parmi un million d’annonces de véhicules par numéro d’immatriculation passe de lent à instantané avec le bon index. Les index occupent de l’espace et ralentissent un peu les écritures; ajoutez-les pour les requêtes que vous exécutez vraiment, pas partout.
Optimiser les requêtes, c’est faire travailler moins la base de données : lire le plan de requête (EXPLAIN), sélectionner seulement les colonnes nécessaires, filtrer tôt et utiliser des index adaptés.
Les requêtes N+1. Vous récupérez 100 voitures, puis lancez une requête de plus par voiture pour obtenir son concessionnaire : 101 requêtes au lieu d’une ou deux. Le code généré par l’IA avec des ORM fait souvent ça. Récupérez les données liées ensemble (une jointure, ou l’option « include » / « eager load » de votre ORM).
Le regroupement de connexions (pooling). Ouvrir une nouvelle connexion à la base pour chaque requête est lent. Un pool réutilise un ensemble fixe de connexions. Trop de connexions peuvent submerger la base; trop peu font attendre les requêtes. C’est particulièrement important sur les plateformes serverless, où chaque instance de fonction peut ouvrir ses propres connexions.
Les réplicas en lecture sont des copies de la base qui répondent aux requêtes de lecture. Elles allègent la base principale, mais ont souvent un léger retard : un utilisateur pourrait ne pas voir sa propre modification pendant un instant.
Réplication, sharding et partitionnement :
- Réplication : garder des copies des mêmes données sur plusieurs machines.
- Partitionnement : diviser une grande table en morceaux plus petits (par exemple par mois), souvent dans une seule base.
- Sharding : répartir les données sur plusieurs serveurs de base de données distincts, chacun en détenant une partie.
Tous ajoutent de la capacité, mais aussi de la complexité. La plupart des apps n’ont pas besoin de sharding avant longtemps.
Migrations et versions du schéma. Les migrations sont des changements contrôlés et versionnés de la structure de votre base. Pendant un déploiement, l’ancienne et la nouvelle version de votre app peuvent tourner en même temps; une migration qui renomme ou supprime une colonne peut donc briser la version encore active. Procédez par étapes sûres : ajoutez la nouvelle colonne, déployez le code qui l’utilise, puis retirez l’ancienne plus tard.
Pourquoi c’est important : la plupart des problèmes du genre « mon app est lente » sont des problèmes de base de données. La solution est généralement un index, une meilleure requête ou moins de requêtes, pas un plus gros serveur.
3. Mise à l’échelle et répartition de charge : que se passe-t-il quand plus d’utilisateurs arrivent?
La limitation du débit plafonne le nombre de requêtes qu’un utilisateur, une adresse IP ou une clé d’API peut faire dans une période. Elle vous protège contre les abus, l’extraction de données, les attaques par force brute sur la connexion et un client qui accapare tout.
La répartition de charge distribue les requêtes sur plusieurs serveurs. Elle ajoute de la capacité et vous garde en ligne si un serveur tombe, mais si tous les serveurs dépendent d’une seule base surchargée, la base reste votre limite.
Les proxys inverses (comme Nginx) se placent devant vos serveurs, reçoivent les requêtes en leur nom et peuvent router le trafic, gérer le TLS, compresser les réponses et mettre en cache.
Les passerelles d’API sont une porte d’entrée gérée pour vos API, qui peut s’occuper du routage, de l’authentification, de la limitation du débit et de la validation des requêtes au même endroit. Elles recoupent les proxys inverses, mais visent spécifiquement la gestion des API.
Mise à l’échelle horizontale ou verticale :
- Horizontale : ajouter des serveurs ou des instances. Plus de capacité et de résilience, mais votre app ne doit pas garder d’état important dans la mémoire d’un seul serveur.
- Verticale : donner plus de processeur ou de mémoire à un serveur. Plus simple, mais il y a un plafond.
La mise à l’échelle automatique ajoute et retire de la capacité selon la charge. Elle a besoin de limites raisonnables : passer à 50 instances ne sert à rien si votre base ne peut en supporter que 10.
La découverte de services permet aux services de se trouver quand leurs adresses changent sans cesse (conteneurs qui démarrent et s’arrêtent), au lieu de coder les adresses IP en dur.
Le DNS traduit les noms de domaine en adresses. Les enregistrements sont mis en cache pendant une période appelée TTL, ce qui explique pourquoi un changement DNS peut prendre du temps à atteindre tout le monde.
Démarrages à froid et limites du serverless. Une fonction serverless qui n’a pas tourné depuis un moment prend plus de temps à démarrer : c’est un démarrage à froid. Les plateformes serverless limitent aussi la durée d’exécution, la mémoire, la taille des requêtes et la concurrence, ce qui les rend mal adaptées à certaines charges (le traitement de longues vidéos, par exemple).
Optimisation des coûts. Plus de serveurs, plus de journaux et plus de transfert de données, tout ça coûte de l’argent. Sachez ce qui fait grimper votre facture, retirez les ressources inutilisées et configurez des alertes de budget, car un bogue de mise à l’échelle automatique peut devenir une surprise très coûteuse.
Pourquoi c’est important : mettre à l’échelle, ce n’est pas seulement « ajouter des serveurs ». C’est savoir où sont vos limites et ce que vous coûte chaque utilisateur de plus.
4. Fiabilité et gestion des défaillances : que se passe-t-il quand quelque chose brise?
Les réseaux tombent. Les API plantent. Les requêtes restent bloquées. Les systèmes fiables s’y attendent.
Les délais d’expiration. N’attendez jamais indéfiniment. Sans délai d’expiration, une seule dépendance lente peut accaparer toutes les ressources de votre serveur.
Les nouvelles tentatives et l’attente exponentielle. Réessayer une requête échouée est souvent correct, mais attendez plus longtemps entre chaque tentative (1 s, 2 s, 4 s…) et ajoutez un peu d’aléatoire (« jitter ») pour que des milliers de clients ne réessaient pas tous au même instant. Plafonnez toujours le nombre de tentatives.
L’idempotence. Une opération est idempotente si la faire deux fois a le même effet que la faire une fois. C’est ce qui rend les nouvelles tentatives sûres. Les API de paiement comme Stripe acceptent une clé d’idempotence pour qu’une nouvelle tentative de « débiter le client » ne le débite pas deux fois.
Les disjoncteurs (circuit breakers) cessent d’appeler une dépendance qui échoue sans arrêt, échouent rapidement pendant un moment, puis la testent de nouveau. Cela protège votre app et laisse au service défaillant le temps de se rétablir.
Les vérifications d’état indiquent aux répartiteurs de charge et aux plateformes si une instance fonctionne, pour n’envoyer le trafic qu’aux instances saines.
Les sondes liveness et readiness (Kubernetes) :
- Liveness : « Ce conteneur est-il bloqué? Redémarre-le. »
- Readiness : « Ce conteneur est-il prêt à recevoir du trafic en ce moment? »
Les confondre cause des pannes. Si votre sonde liveness échoue chaque fois que la base est brièvement indisponible, Kubernetes redémarrera sans cesse des conteneurs parfaitement sains.
Le basculement (failover) passe à un système de secours quand le principal tombe. Il exige une détection fiable des pannes et un plan pour éviter que deux systèmes se croient tous deux aux commandes.
Sauvegardes et reprise après sinistre. Les sauvegardes protègent contre la perte, la suppression et la corruption des données. La reprise après sinistre est le plan complet pour rétablir le service : combien de données vous pouvez perdre, combien de temps vous pouvez être hors ligne, qui fait quoi. Une sauvegarde jamais restaurée est un espoir, pas un plan. Testez les restaurations régulièrement.
Les déploiements multirégions font tourner votre service dans plus d’une région géographique, pour la résilience et une latence plus faible. Ils posent des problèmes difficiles (réplication des données, routage, basculement, coûts) et n’ont de sens qu’en cas de besoin réel.
L’ingénierie du chaos provoque volontairement des pannes contrôlées (arrêter une instance, ralentir une dépendance) pour prouver que votre système tient le coup. Commencez petit, fixez des limites claires et prévoyez un moyen d’arrêter l’expérience.
Incidents en production, garde et post-mortems. Un incident est tout ce qui nuit à un service en ligne ou à ses utilisateurs. Être de garde signifie que quelqu’un est clairement responsable d’intervenir. Un post-mortem consigne ensuite ce qui s’est passé, pourquoi, comment ç’a été réglé et ce qui changera, en cherchant à améliorer le système plutôt qu’à blâmer quelqu’un.
Pourquoi c’est important : la fiabilité, ce n’est pas de ne jamais tomber en panne. C’est remarquer les pannes rapidement, limiter les dégâts et se rétablir de façon prévisible.
5. Concurrence et systèmes distribués : et si deux choses arrivaient en même temps?
Certains des pires bogues n’apparaissent que lorsque des opérations se chevauchent.
Les situations de concurrence (race conditions). Deux clients essaient d’acheter le dernier billet. Les deux requêtes vérifient « reste-t-il un billet? », voient oui, et achètent. Vous venez de vendre deux fois le même billet.
La solution la plus simple : faire de la vérification et de la mise à jour une seule opération atomique dans la base de données :
UPDATE events
SET tickets_sold = tickets_sold + 1
WHERE id = 42 AND tickets_sold < capacity;
Si la requête ne met à jour aucune ligne, l’événement est complet. Deux requêtes ne peuvent pas gagner toutes les deux.
Le verrouillage optimiste présume que les conflits sont rares. Chaque enregistrement a un numéro de version; à l’enregistrement, vous vérifiez que la version n’a pas changé depuis votre lecture. Si elle a changé, réessayez ou refusez.
Le verrouillage pessimiste verrouille l’enregistrement pendant que vous y travaillez pour que personne d’autre ne le modifie. Plus sûr quand les conflits sont fréquents, mais un verrouillage lourd ralentit tout le monde.
Les verrous distribués coordonnent l’accès entre plusieurs serveurs (souvent avec Redis ou une base de données). Ils sont délicats : un verrou peut expirer pendant que vous travaillez encore, et un serveur peut planter en le détenant. Pour la plupart des modifications de données, une transaction ou une mise à jour atomique comme celle ci-dessus est plus simple et plus sûre.
Les interblocages (deadlocks). La transaction A détient la ligne 1 et attend la ligne 2; la transaction B détient la ligne 2 et attend la ligne 1. Aucune ne peut continuer. Les bases de données le détectent et en annulent une; votre code doit donc gérer cette erreur, généralement en réessayant.
La sûreté des fils d’exécution. Du code est thread-safe s’il se comporte correctement quand plusieurs fils l’exécutent en même temps. Des données partagées et modifiables sans coordination produisent des bogues aléatoires et difficiles à reproduire.
Fuites de mémoire et ramasse-miettes. Une fuite de mémoire, c’est de la mémoire que votre programme garde sans en avoir besoin, si bien que l’utilisation augmente jusqu’au plantage. Le ramasse-miettes libère la mémoire que plus rien ne référence, mais il ne peut rien si votre code garde encore des références, comme un cache en mémoire qui grossit sans fin ou des écouteurs jamais retirés.
Les transactions distribuées tentent de faire réussir ou échouer ensemble des changements répartis sur plusieurs services ou bases. C’est difficile et lent entre des systèmes indépendants, et c’est pourquoi beaucoup d’équipes utilisent plutôt des sagas.
Le patron Saga divise un long processus d’affaires en étapes, chacune avec une « annulation » (une action compensatoire). Réservation : réserver le siège, autoriser le paiement, confirmer la réservation. Si la confirmation échoue, libérer le siège et annuler l’autorisation de paiement.
Le théorème CAP. Quand le réseau coupe votre système en deux (une partition), une base distribuée doit choisir : rester disponible au risque de renvoyer des données périmées, ou rester cohérente et refuser certaines requêtes. C’est un compromis à faire pendant les pannes, pas « choisir deux sur trois pour toujours ».
La cohérence à terme. Des copies des données peuvent diverger un court moment, puis se rattraper. Votre app doit tolérer qu’une valeur que l’utilisateur vient d’enregistrer n’apparaisse pas partout immédiatement.
L’élection d’un leader désigne un serveur pour coordonner certaines tâches (comme exécuter une tâche planifiée une seule fois). Elle doit empêcher deux serveurs de se croire tous deux leaders.
Partitions réseau et décalage d’horloge. Des serveurs peuvent perdre contact tout en continuant de tourner, et leurs horloges ne sont jamais parfaitement synchronisées. Ne comptez pas sur l’arrivée instantanée des messages ni sur la concordance exacte des horodatages de différentes machines.
Pourquoi c’est important : du code qui fonctionne pour une requête peut échouer quand plusieurs requêtes se disputent les mêmes données. Dès que votre app s’étend sur plusieurs machines, les délais et les pannes partielles sont normaux, pas exceptionnels.
6. Tâches en arrière-plan et travail piloté par événements
Tout n’a pas besoin d’être terminé avant que l’utilisateur reçoive une réponse.
Les tâches cron s’exécutent selon un horaire : rapports de nuit, nettoyage des enregistrements expirés, synchronisation des données. Surveillez-les, et assurez-vous que deux exécutions ne peuvent pas se chevaucher ni faire deux fois le même travail.
Les files de messages gardent du travail à traiter plus tard. Votre paiement peut placer « envoyer le courriel de confirmation » dans une file et répondre tout de suite au client, au lieu de le faire attendre le fournisseur de courriel.
Pub/Sub (publication/abonnement) permet à un événement d’atteindre plusieurs écouteurs. Un seul événement OrderPlaced peut mettre à jour l’inventaire, enregistrer l’analytique et aviser le client, sans que le code de la commande les appelle chacun directement.
L’architecture pilotée par événements organise le système autour de ces événements. Elle réduit les dépendances directes entre les parties du système, mais rend le débogage, l’ordre et la cohérence plus difficiles.
La plupart des files livrent un message au moins une fois; le même message peut donc arriver deux fois. Vos gestionnaires doivent être idempotents (voir la section 4).
Les files de lettres mortes recueillent les messages qui échouent encore après les tentatives permises, pour que vous puissiez les examiner et les relancer au lieu de les perdre ou de réessayer sans fin.
La contre-pression (backpressure) empêche un producteur rapide de submerger un consommateur lent, en limitant la taille de la file, en ralentissant l’entrée ou en refusant le travail en trop. Sans elle, un court ralentissement peut grossir jusqu’à ce que le système manque de mémoire.
Pourquoi c’est important : le travail asynchrone rend les apps plus rapides en apparence, mais votre système doit gérer les tâches retardées, en double, dans le désordre ou qui ne se terminent jamais.
7. API et communication : comment vos systèmes se parlent
TCP ou UDP. TCP offre une connexion fiable et ordonnée : tout arrive, dans l’ordre. UDP envoie simplement des paquets sans garantie de livraison, mais avec moins de surcharge, ce qui convient à la vidéo en direct, aux jeux et aux appels vocaux. Aucun n’est « meilleur »; ça dépend du besoin.
HTTP/2 et HTTP/3. HTTP/2 envoie plusieurs requêtes en même temps sur une seule connexion (multiplexage). HTTP/3 fonctionne sur QUIC, bâti sur UDP, et gère mieux les paquets perdus et les changements de réseau (comme passer du Wi-Fi aux données mobiles).
Les mises à jour en temps réel, de trois façons :
- WebSockets : une connexion persistante dans les deux sens. Idéal pour le clavardage, le multijoueur et l’édition collaborative.
- Server-Sent Events (SSE) : le serveur diffuse des mises à jour au navigateur par HTTP normal; le client ne renvoie rien par ce canal. Idéal pour les fils en direct, les notifications et les réponses d’IA en continu.
- Long polling : le client demande, le serveur garde la requête ouverte jusqu’à ce qu’il y ait du nouveau (ou un délai d’expiration), puis le client redemande. Une solution de repli quand les deux autres ne sont pas disponibles.
gRPC est un cadre rapide pour les appels entre services. Il fonctionne sur HTTP/2, utilise Protocol Buffers par défaut et permet la diffusion en continu. Les navigateurs ont besoin de gRPC-Web ou d’un proxy pour l’utiliser.
Les webhooks, c’est un autre système qui appelle *votre* serveur quand quelque chose arrive, comme « paiement réussi ». Traitez-les avec soin :
- vérifiez la signature, pour savoir qu’il vient vraiment du fournisseur;
- répondez rapidement et faites le gros du travail en arrière-plan;
- attendez-vous à recevoir le même événement plus d’une fois, et dans le désordre.
Le versionnage d’API permet à votre API d’évoluer sans briser les apps qui l’utilisent déjà (par exemple /v1/ et /v2/), avec un plan clair pour retirer les anciennes versions.
Le versionnage sémantique utilise MAJEUR.MINEUR.CORRECTIF : majeur pour les changements incompatibles, mineur pour les nouvelles fonctions rétrocompatibles, correctif pour les corrections rétrocompatibles. Les numéros de version expriment une intention; ils ne garantissent pas que rien n’a brisé.
Pourquoi c’est important : chaque connexion repose sur des hypothèses de livraison, de délai, d’identité et de compatibilité. Rendez ces hypothèses explicites.
8. Sécurité : les problèmes que vous ne voulez pas découvrir en production
Une page de connexion qui fonctionne ne rend pas une app sécuritaire.
Le contrôle d’accès défaillant est le risque numéro un du Top 10 de l’OWASP, et celui que je vois le plus dans les apps générées par l’IA. Être connecté, ce n’est pas être autorisé. Si changer /api/orders/123 pour /api/orders/124 affiche la commande de quelqu’un d’autre, vous avez un bogue grave. Vérifiez sur le serveur, à chaque requête, que cet utilisateur a le droit d’accéder à cet enregistrement précis. Si vous utilisez Supabase ou Firebase, assurez-vous que la Row Level Security ou les règles de sécurité sont activées et réellement testées.
La gestion des secrets. Les clés d’API, mots de passe de base de données et secrets de signature ne doivent jamais se rendre au navigateur ni dans votre historique Git. Dans Next.js, tout ce qui commence par NEXT_PUBLIC_ (ou VITE_ dans Vite) est intégré à du code que n’importe qui peut lire. Gardez les secrets sur le serveur, limitez qui peut les lire et renouvelez-les en cas de fuite.
L’injection SQL survient quand une entrée de l’utilisateur est collée dans une requête SQL, ce qui permet à un attaquant de changer ce qu’elle fait. Utilisez des requêtes paramétrées ou les méthodes sûres de votre ORM; ne construisez jamais du SQL par concaténation de chaînes.
Le XSS (cross-site scripting) survient quand un attaquant fait exécuter son script dans le navigateur d’autres utilisateurs par votre site. Laissez votre framework échapper les sorties, et soyez très prudent avec le HTML brut (dangerouslySetInnerHTML, v-html) et le contenu généré par les utilisateurs.
Le CSRF (cross-site request forgery) pousse le navigateur d’un utilisateur connecté à envoyer une requête qu’il n’a pas voulue. Les protections comprennent les jetons CSRF, les témoins SameSite et la vérification de l’origine de la requête.
Le SSRF (server-side request forgery). Si votre app récupère une URL fournie par l’utilisateur (aperçus de liens, importation d’images), un attaquant peut la diriger vers vos services internes ou les points d’accès de métadonnées infonuagiques. Validez et restreignez les destinations que votre serveur a le droit d’atteindre.
Le CORS est une règle du navigateur qui détermine quels autres sites peuvent lire les réponses de votre API depuis leurs scripts. Ce n’est pas de l’authentification : il n’empêche pas les requêtes venant de scripts, de serveurs ou d’outils comme curl. Ne « réglez » pas des erreurs CORS avec * sur une API qui utilise des témoins ou renvoie des données privées.
WAF et protection DDoS. Un pare-feu applicatif Web filtre le trafic HTTP malveillant; la protection DDoS absorbe les vagues de trafic qui visent à vous mettre hors ligne. Les deux aident, et aucun ne corrige les bogues de votre propre code.
L’IAM (gestion des identités et des accès) contrôle quelles personnes et quels services peuvent accéder à quelles ressources. Appliquez le moindre privilège : donnez à chaque personne, clé et service seulement les permissions nécessaires.
OAuth permet à une app d’obtenir un accès limité au compte d’un utilisateur ailleurs sans jamais voir son mot de passe (« Se connecter avec Google » l’utilise). OAuth concerne l’autorisation; OpenID Connect, bâti par-dessus, gère l’identité (qui est l’utilisateur).
La rotation des JWT. Les JSON Web Tokens transportent des informations signées sur un utilisateur. Donnez-leur une courte durée de vie, faites tourner les jetons de rafraîchissement, prévoyez un moyen de révoquer l’accès et renouvelez les clés de signature. Un JWT n’est pas sécuritaire du seul fait d’être signé, et n’importe qui peut lire son contenu.
TLS et chiffrement :
- Chiffrement en transit : protège les données qui circulent entre les systèmes. Le TLS (le « S » de HTTPS) est la façon de le faire.
- Chiffrement au repos : protège les données stockées, comme les fichiers de base de données et les sauvegardes.
Le chiffrement ne vaut que la protection de ses clés.
Les dépendances. Les assistants IA suggèrent parfois des paquets désuets, vulnérables ou qui n’existent même pas, et des attaquants enregistrent ces noms inventés. Vérifiez qu’un paquet est réel et maintenu avant de l’installer, et lancez npm audit (ou l’équivalent de votre écosystème).
Pourquoi c’est important : les failles de sécurité font fuir les données des utilisateurs, permettent le piratage de comptes, coûtent de l’argent et détruisent la confiance. Elles coûtent bien moins cher à prévenir qu’à réparer.
9. Déploiement et infrastructure : mettre le code en production en toute sécurité
Le CI/CD (intégration et livraison/déploiement continus) automatise les tests, la compilation et la publication. Un pipeline peut lancer les tests, vérifier les dépendances, compiler l’app et déployer une version approuvée.
Docker emballe votre app avec tout ce dont elle a besoin, pour qu’elle tourne de la même façon sur votre portable et en production. Les conteneurs ne sont pas, à eux seuls, une frontière de sécurité complète.
Kubernetes exécute et gère des conteneurs à grande échelle : planification, mise à l’échelle, vérifications d’état et déploiements. C’est puissant et complexe, et la plupart des petites apps n’en ont pas besoin.
L’infrastructure en tant que code et Terraform. Définissez serveurs, bases de données et réseaux dans des fichiers versionnés au lieu de cliquer dans un tableau de bord. Terraform est un outil populaire pour ça. Les changements peuvent être révisés comme du code et reproduits de façon fiable.
Les charts Helm emballent et configurent les applications pour Kubernetes. De mauvaises valeurs dans un chart peuvent quand même faire tomber la production.
Les drapeaux de fonctionnalité activent ou désactivent des fonctions sans nouveau déploiement, ce qui est excellent pour les lancements progressifs et les arrêts d’urgence. Retirez les anciens drapeaux, sinon ils s’accumulent et sèment la confusion.
Stratégies de mise en production :
- Bleu-vert : faites tourner la nouvelle version à côté de l’ancienne, basculez le trafic, et revenez instantanément en arrière en cas de problème.
- Canari : envoyez d’abord la nouvelle version à une petite partie des utilisateurs, surveillez les indicateurs, puis élargissez.
- Progressif : remplacez graduellement les anciennes instances par des nouvelles. Les deux versions cohabitent un moment; elles (et la base de données) doivent donc fonctionner ensemble.
Les retours en arrière remettent la version précédente. Les changements de base de données, les courriels envoyés et les paiements traités ne peuvent pas simplement être annulés; concevez donc migrations et mises en production en pensant au retour en arrière.
L’enfer des dépendances, c’est quand des paquets exigent des versions incompatibles les uns des autres. Versionnez votre fichier de verrouillage, mettez vos dépendances à jour régulièrement par petites étapes et lancez vos tests.
Pourquoi c’est important : livrer est un processus, pas un bouton. Des mises en production sûres demandent de la reproductibilité, des vérifications de compatibilité, de la validation et un moyen de revenir en arrière.
10. Surveillance et observabilité : comment savoir que quelque chose cloche?
Si votre app brise à 2 h du matin, il vous faut plus qu’une capture d’écran envoyée par un utilisateur.
La journalisation consigne les événements et les erreurs avec assez de contexte pour les comprendre. Ne journalisez jamais de mots de passe, de jetons ni de données personnelles inutiles.
Les métriques sont des nombres dans le temps : nombre de requêtes, taux d’erreur, temps de réponse, processeur et mémoire. Elles montrent les tendances et les changements soudains.
Surveillance et alertes. La surveillance suit la santé du système; les alertes avisent quelqu’un quand une action est nécessaire. Chaque alerte devrait mener à une action. Les alertes trop bruyantes apprennent aux gens à toutes les ignorer.
Le traçage distribué suit une requête dans chaque service qu’elle traverse (passerelle, service de commandes, base de données, fournisseur de paiement), pour voir où elle a ralenti ou échoué.
L’observabilité, c’est pouvoir comprendre ce qui se passe à l’intérieur de votre système à partir de ses sorties (journaux, métriques et traces), y compris des problèmes que vous n’aviez pas prévus.
SLI, SLO et budgets d’erreur :
- SLI (indicateur de niveau de service) : ce que vous mesurez, comme le pourcentage de requêtes réussies.
- SLO (objectif de niveau de service) : votre cible, comme 99,9 % de requêtes réussies sur 30 jours.
- Budget d’erreur : ce que cette cible permet d’échouer. 99,9 % laisse 0,1 %, soit 1 requête sur 1 000, ou environ 43 minutes d’arrêt total dans un mois de 30 jours.
Si vous respectez votre budget, livrez des fonctions. Si vous l’avez épuisé, concentrez-vous sur la fiabilité.
Pourquoi c’est important : on ne peut ni améliorer ni maintenir ce qu’on ne voit pas.
Les questions à poser avant de faire confiance au code généré par l’IA
Quand un assistant IA écrit du code pour vous, demandez-vous :
- Performance : que se passe-t-il quand les données et le trafic sont multipliés par 100?
- Données : les requêtes sont-elles efficaces, et les bons index sont-ils en place?
- Concurrence : que se passe-t-il si deux requêtes modifient le même enregistrement en même temps?
- Accès : un utilisateur peut-il voir ou modifier des données qui ne sont pas les siennes?
- Secrets : une clé ou un mot de passe est-il accessible depuis le navigateur ou dans le dépôt?
- Défaillance : que se passe-t-il quand une API externe expire ou renvoie une erreur?
- Nouvelles tentatives : une requête répétée pourrait-elle créer un paiement, une réservation ou un enregistrement en double?
- Déploiement : la nouvelle version peut-elle tourner sans risque avec le schéma de base de données actuel?
- Observabilité : comment saurai-je quand ça échoue en production?
- Reprise : puis-je restaurer les données et revenir à un état fonctionnel?
Ensuite, testez les réponses. L’explication d’une IA sur son propre code ne prouve pas que le code est correct.
Une règle pratique pour les vibe coders
Utilisez l’IA pour aller plus vite, mais ne lui confiez pas votre jugement d’ingénieur.
Un petit site portfolio n’a pas besoin de transactions distribuées, d’un déploiement multirégion ni d’une grappe Kubernetes. Une plateforme de paiement, un système de billetterie, une place de marché ou tout ce qui contient des données client sensibles demande une attention sérieuse au contrôle d’accès, à la concurrence, à l’idempotence, à la surveillance et à la reprise.
Le but n’est pas d’appliquer chaque patron de cette liste. C’est de savoir quand chacun devient pertinent et ce qu’il coûte.
Commencez simple. Mesurez le comportement réel. Testez les cas d’échec. Améliorez la conception quand les données ou les besoins l’exigent.
Et avant de déployer du code généré par l’IA, posez-vous une question :
Si ça brise en production, comprendrai-je ce qui a mal tourné et saurai-je comment me rétablir?
Si la réponse est non, c’est la prochaine chose à apprendre.
L’IA peut vous aider à écrire le code. S’assurer que le logiciel est sûr, fiable et adapté aux gens qui l’utilisent reste votre travail.
Appliquer cette liste à votre propre projet
Copiez cette requête dans Claude Code, Cursor ou un autre assistant de code IA ouvert dans votre projet, et remplissez la courte partie « À propos de mon projet ». Il examine votre code selon les dix domaines, montre où se trouve chaque problème et ne change rien sans votre approbation.
Requête de préparation à la production
Tu es ingénieur logiciel principal et tu révises mon projet avant sa mise en production. Ne modifie encore aucun code. Inspecte d’abord le code, puis fais ton rapport.

À propos de mon projet (à remplir) :
- Ce qu’il fait :
- Utilisateurs et trafic prévus :
- Pile technologique et hébergement :
- Traite-t-il des paiements ou des données sensibles? (oui/non)

Évalue le projet selon ces dix domaines. Si quelque chose ne s’applique vraiment pas à un projet de cette taille, marque-le « Sans objet » et explique pourquoi.

1. Performance et cache : pages ou points d’accès lents, cache et invalidation, CDN et fichiers statiques, cache de compilation.
2. Bases de données et requêtes : index manquants, requêtes N+1, requêtes inefficaces, regroupement de connexions (surtout en serverless), migrations sûres quand l’ancien et le nouveau code tournent ensemble.
3. Mise à l’échelle et trafic : limitation du débit sur les points d’accès publics et de connexion, état gardé dans la mémoire du serveur, mise à l’échelle automatique et limites du serverless (délais, démarrages à froid), risques de coûts.
4. Fiabilité : délais d’expiration et nombre limité de tentatives avec attente progressive sur les appels externes, idempotence des paiements, réservations et webhooks, vérifications d’état, sauvegardes et test de restauration.
5. Concurrence : situations de concurrence (par exemple deux utilisateurs qui achètent le dernier article), logique « vérifier puis écrire » qui devrait être une seule opération atomique, verrouillage, fuites de mémoire.
6. Tâches en arrière-plan : tâches cron qui peuvent se chevaucher ou s’exécuter deux fois, gestionnaires de files non idempotents, gestion des échecs ou file de lettres mortes manquante.
7. API et communication : vérification des signatures de webhooks et gestion des doublons, versionnage d’API, fermeture des connexions WebSocket ou SSE.
8. Sécurité : contrôle d’accès défaillant (un utilisateur peut-il lire ou modifier les données d’un autre en changeant un identifiant?), secrets exposés au navigateur ou versionnés dans git, injection SQL, XSS, CSRF, SSRF, réglages CORS, gestion des sessions et des JWT, règles de base de données (RLS Supabase, règles Firebase), dépendances vulnérables, désuètes ou inexistantes.
9. Déploiement : CI/CD et tests, variables d’environnement, plan de migration et de retour en arrière, fichier de verrouillage et santé des dépendances.
10. Surveillance : suivi des erreurs, journaux utiles sans données sensibles, alertes. Comment saurais-je que ça a brisé à 2 h du matin?

Pour chaque constat, donne :
- Le domaine et un titre d’une ligne
- La gravité : Critique / Élevée / Moyenne / Faible
- La preuve : chemin exact du fichier et ligne, ou le point d’accès
- Pourquoi c’est important pour ce projet
- La correction la plus simple qui règle le problème

Règles :
- Ne signale que ce que tu peux confirmer dans le code. Mets ce que tu soupçonnes sans pouvoir le confirmer sous « À vérifier », avec ce que je devrais vérifier.
- Ne recommande pas d’infrastructure complexe (Kubernetes, microservices, multirégion) à moins que ce projet en ait clairement besoin.

Termine par :
1. Un tableau des dix domaines, chacun marqué Bon / À améliorer / Sans objet / Impossible à vérifier.
2. Les 5 corrections prioritaires, dans l’ordre où je devrais les faire.
3. Un verdict : est-ce prêt pour la production? Sinon, qu’est-ce qui doit être corrigé en premier?

Attends mon approbation avant de modifier du code.